

この記事のポイント
- RyXeonの記事URLがprotocol・host・pathなどへ分かれた
- ?ref=xはquery、#stepsはfragmentとして別欄に出た
- サーバーへ届く範囲とページ内位置を切り分けて読める
サムネイルはイメージ写真。写真の配布元:Unsplash(利用許諾)。本文の画面は実際の操作時に撮影した。
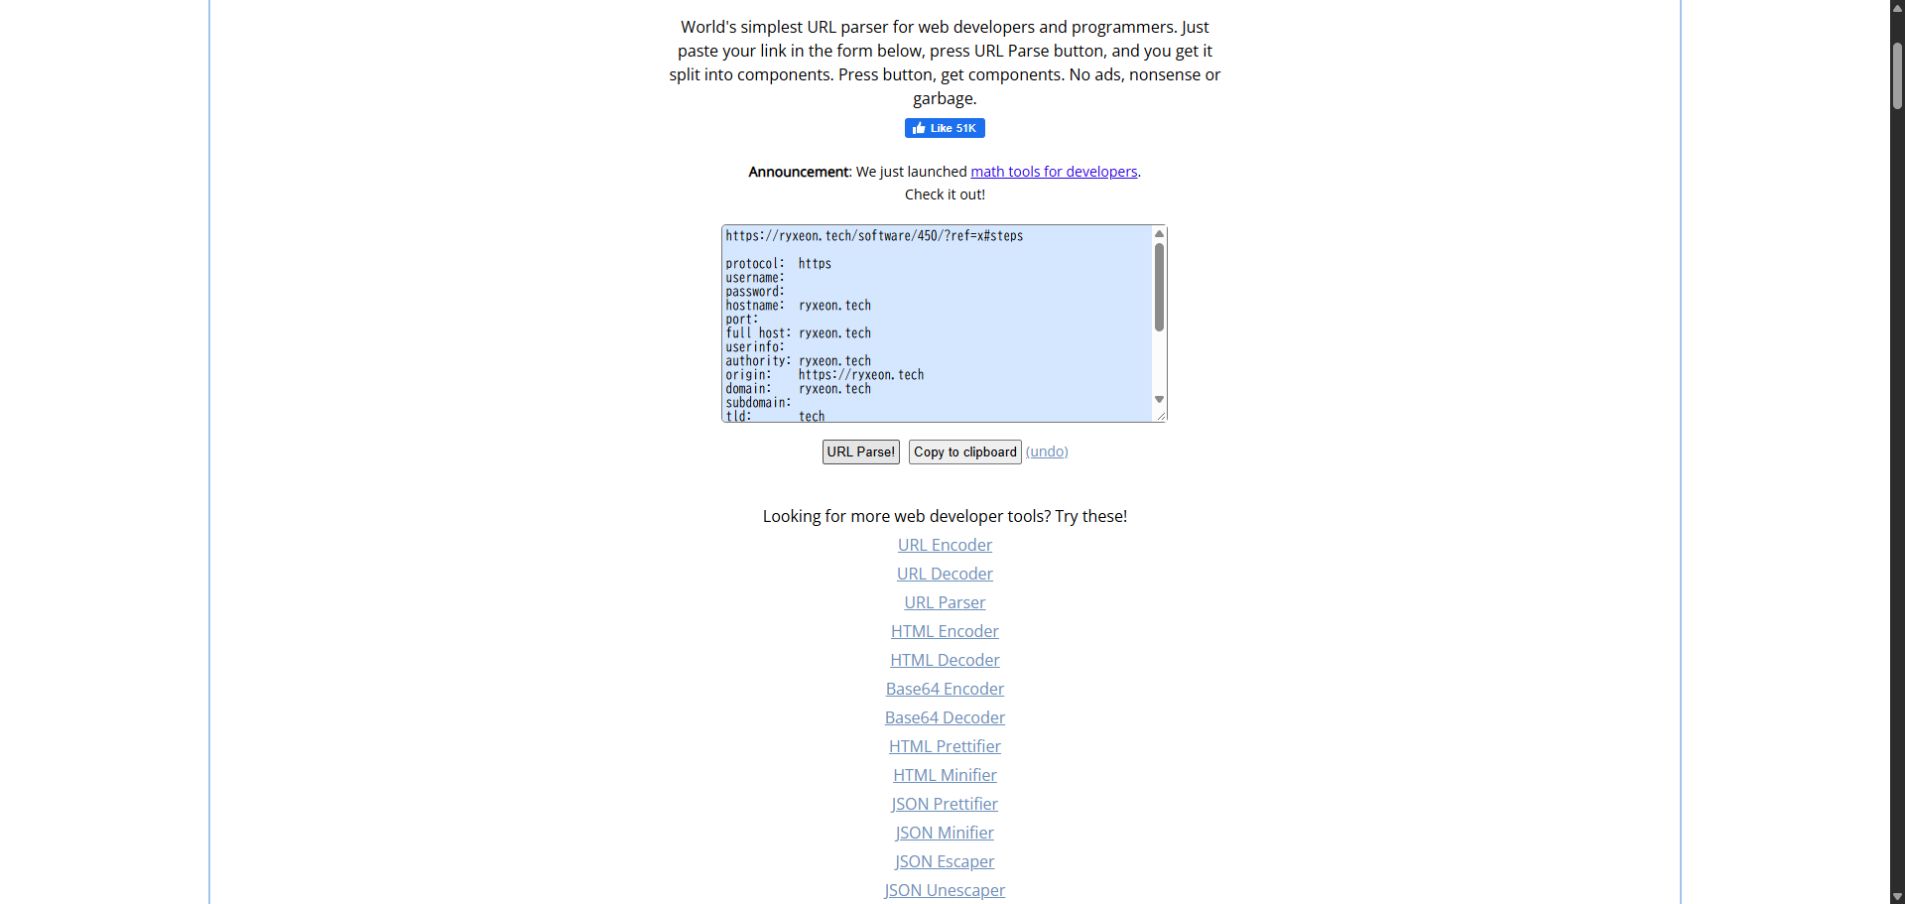
検証環境:2026年10月12日、Windows上のGoogle Chrome。Browserling URL Parserを無料・未ログインで利用し、公開中のRyXeon記事URLを入力した。
URLは長い1本の文字列に見えるが、通信先、ページの場所、計測用の値、ページ内位置が別々に含まれている。今回はhttps://ryxeon.tech/software/450/?ref=x#stepsを解析した。
画面ではprotocolがhttps、hostnameがryxeon.tech、pathnameが/software/450/、queryがref=x、fragmentがstepsになった。?より後ろと#より後ろは、似て見えても別の部品である。
操作手順
- URL Parserを開く。
- URLを入力欄へ貼り付ける。
- 「URL Parse!」を押す。
- hostname、pathname、query、fragmentの4行を読む。
queryとfragmentの使われ方
queryは?ref=xの部分で、流入元などの値をページへ渡す用途に使われる。fragmentは#stepsの部分で、同じページ内の見出しへ移動する用途が中心である。今回の解析結果ではresourceに/software/450/?ref=x#stepsがまとまり、各部品との対応も確認できた。
#以降のfragmentは通常、HTTPリクエストの対象URLとしてサーバーへ送られない。アクセス解析やサーバー側処理へ値を渡す設計ではqueryとの違いが判断に影響する。
コメント