

この記事のポイント
- [email protected]は完全に抽出された
- +tokyoは残った
- example.co.jpの末尾.jpは出力されなかった
サムネイルはイメージ写真。写真の配布元:Unsplash(利用許諾)。本文の画面は実際の操作時に撮影した。
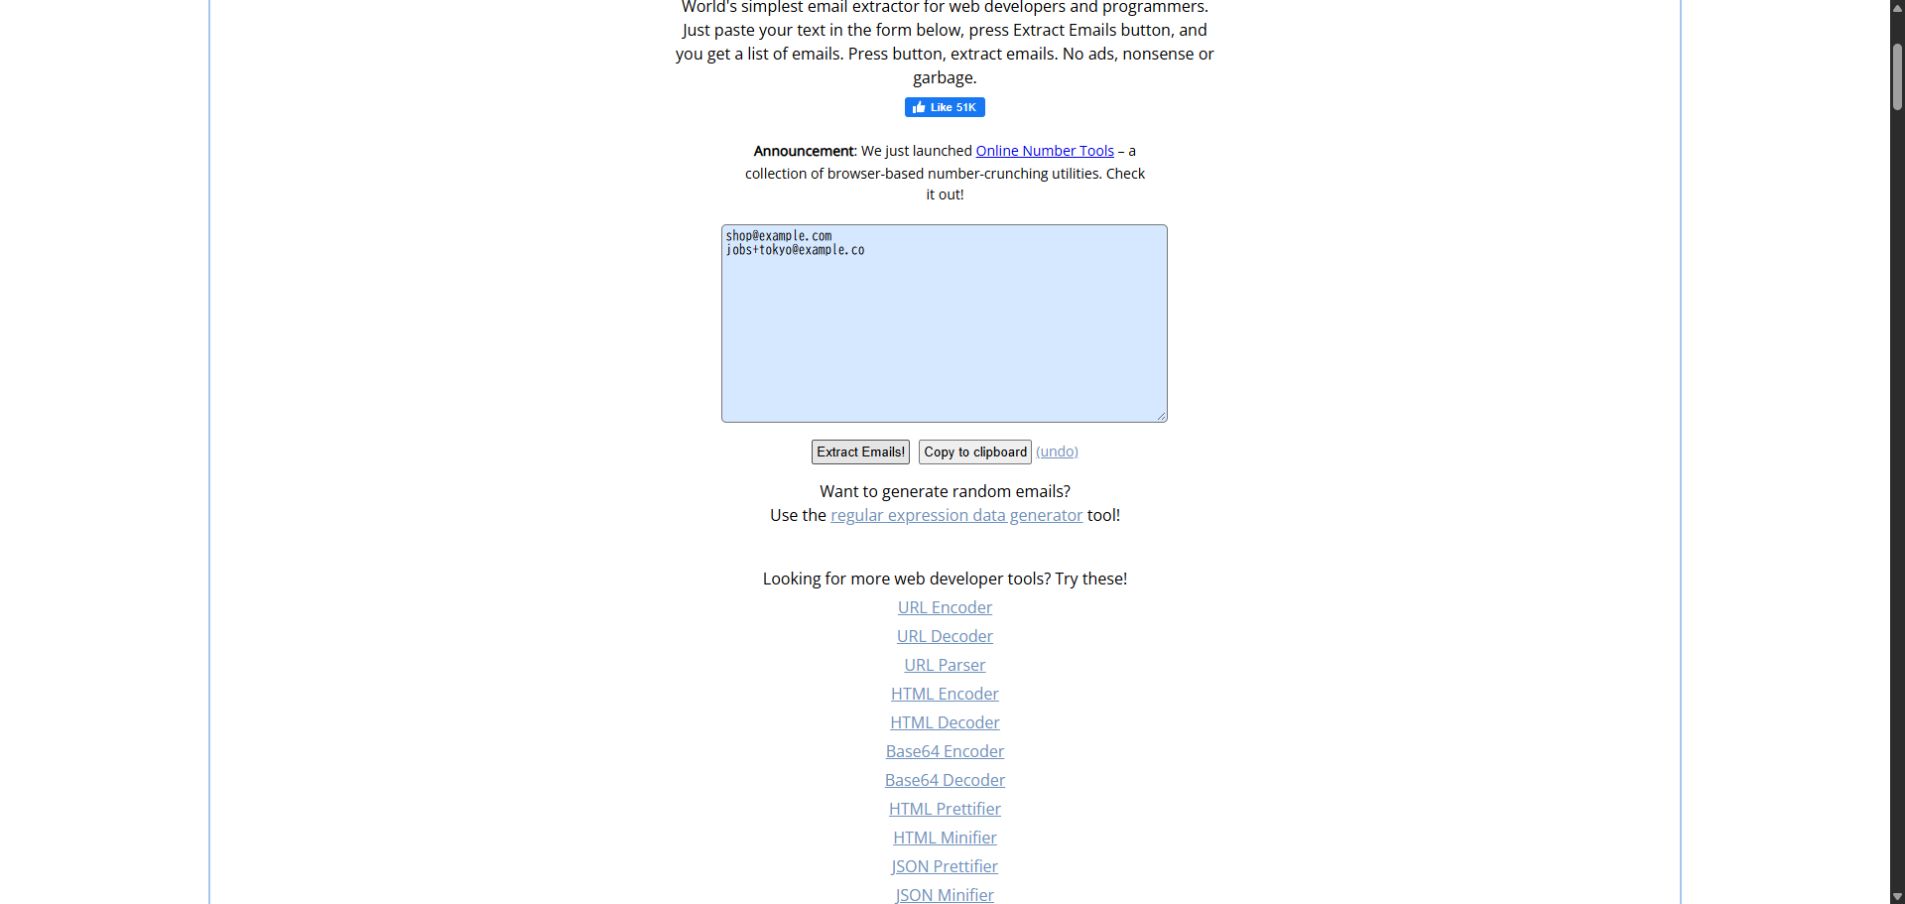
検証環境:2026年10月14日、Windows上のGoogle Chrome。Browserling Email Extractorを無料・未ログインで利用し、example.com系の架空アドレスだけを入力した。
日本語文からメールアドレスだけを抜き出せるか、一般的な.comと複数階層の.co.jp、さらに+を含むローカル部を混ぜて試した。
[email protected]は完全に抽出された。一方、[email protected]は[email protected]で止まった。+tokyoは残ったが、末尾の.jpが欠けた。
操作手順
- Email Extractorを開く。
- 2種類の架空メールアドレスとURLを含む日本語文を貼り付ける。
- 「Extract Emails!」を押す。
- 元のアドレスと2行の出力を比較する。
今回の画面ではco.jpアドレスを完全には抽出できなかった。抽出件数だけを確認せず、出力された各アドレスが元文と一致するか照合したい。
URLはメールとして出力されなかった
同じ文に入れたhttps://example.comは出力対象外だった。メールらしい部分だけを2行へ分ける機能は動いたが、ドメイン末尾の扱いには限界が見えた。


コメント