この記事のポイント
- Gemini 3.8 Flash TTSは役柄、感情、話速などを指定した音声生成に対応する。
- 実在人物の声を複製する場合、Googleは本人の音声による同意確認を求める。
- 生成音声にはSynthIDの透かしが入るが、公開時の説明や事実確認も必要だ。
サムネイルはイメージ写真。写真の配布元:Unsplash(利用許諾)。紹介するサービスの画面ではない。
Googleは2026年9月23日、Gemini 3.8 Flash TTSとFlash-Lite TTSを発表した。100以上の言語・方言に対応し、役柄、アクセント、感情、話速を言葉で指定できる。二人の会話や長い朗読も一つの原稿から作れる。
最初は架空の声から試す
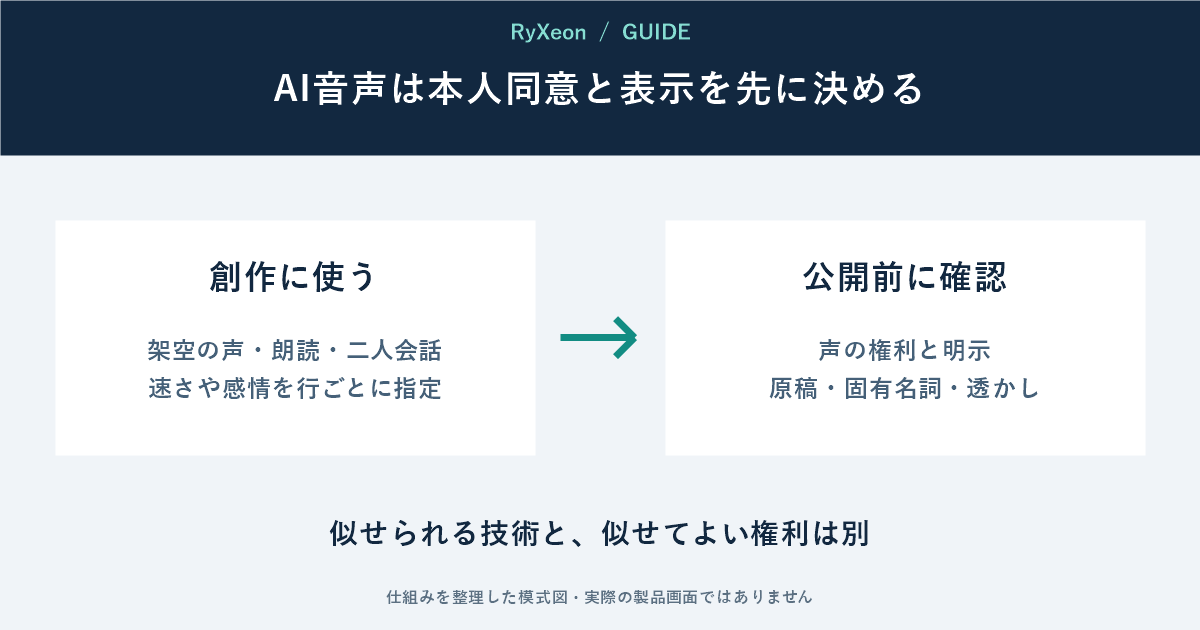
商品説明、学習用朗読、ゲームの仮ボイスなど、実在人物へ似せる必要がない用途から始めたい。行ごとに「落ち着いて」「少し間を置く」と指示し、固有名詞、数字、外国語の発音を人が聞いて修正する。
技術的に声を似せられることと、その声を使う権利があることは別である。
本人に無断で家族、同僚、著名人へ似せ、本人の発言のように公開しない。詐欺、なりすまし、誤解を生む用途を避け、依頼を受けた制作でも同意範囲を記録する。
同意確認と透かしだけへ任せない
Googleは音声複製時に、参照話者本人による口頭の同意録音を照合すると説明している。生成した全音声には検出用のSynthIDが埋め込まれる。それでも、視聴者にAI音声と分かる説明や、原稿内容の事実確認は制作者の仕事だ。
提供先はGoogle AI Studio、Gemini API、Gemini Notebook、Google Vidsなどで異なり、機能は順次展開される。地域制限や料金、利用規約を実際の画面で確認する。
出典:Google 「Gemini 3.8 text-to-speech says hello」(2026年9月23日)。確認:2026年9月25日。
コメント